Monitoring Server: 4 Metrik Wajib yang Harus Dipantau Tim IT
Panduan pemantauan kesehatan server bisnis: metrik vital CPU, Memory Leak, Disk I/O, dan Network Error Rate untuk mendeteksi bottleneck dan mencegah server down.
Jawaban singkat
Yang perlu dipahami sebelum membaca lebih jauh
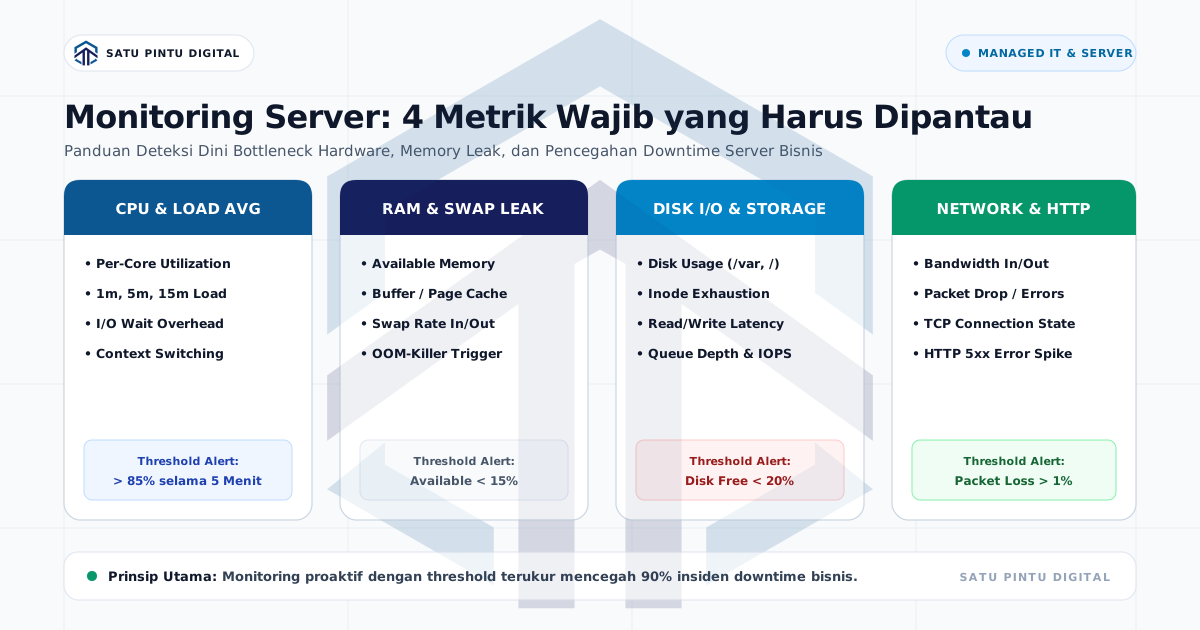
- Empat metrik vital yang wajib dipantau secara real-time adalah: CPU Utilization & Load Average, Available Memory & Swap Rate, Disk Space & I/O Wait Overhead, serta Network Error & Packet Loss.
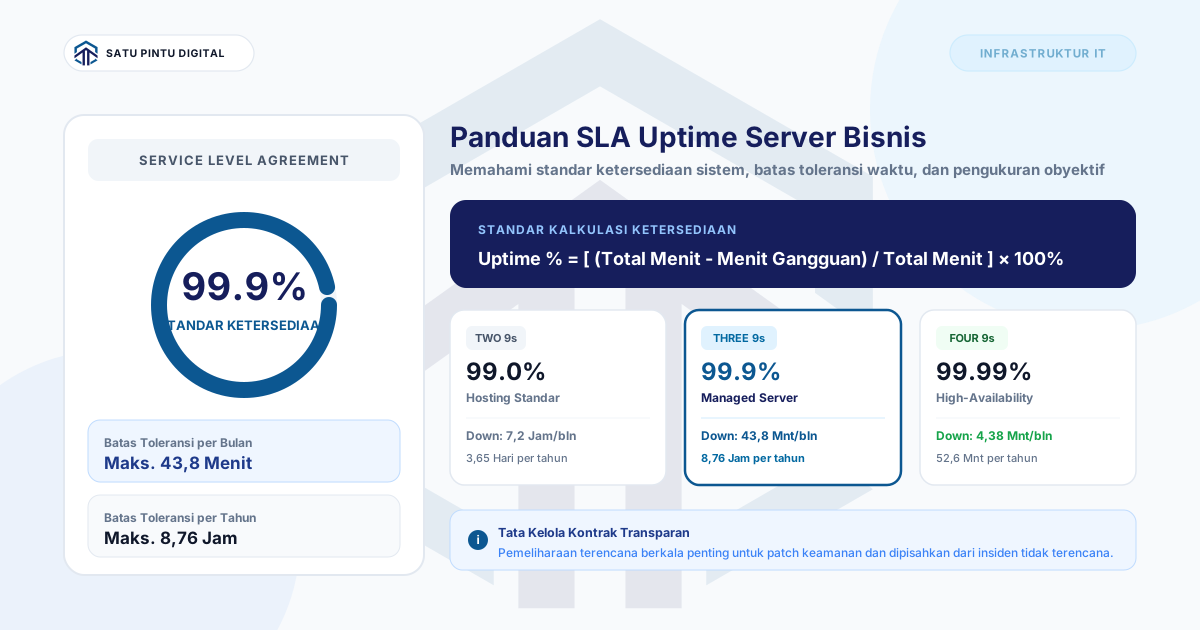
- Monitoring proaktif dengan penetapan batas peringatan (threshold) bertingkat (Warning di 75%, Critical di 85%) memungkinkan tim IT menyelesaikan akar masalah sebelum pelanggan menyadari adanya gangguan layanan.
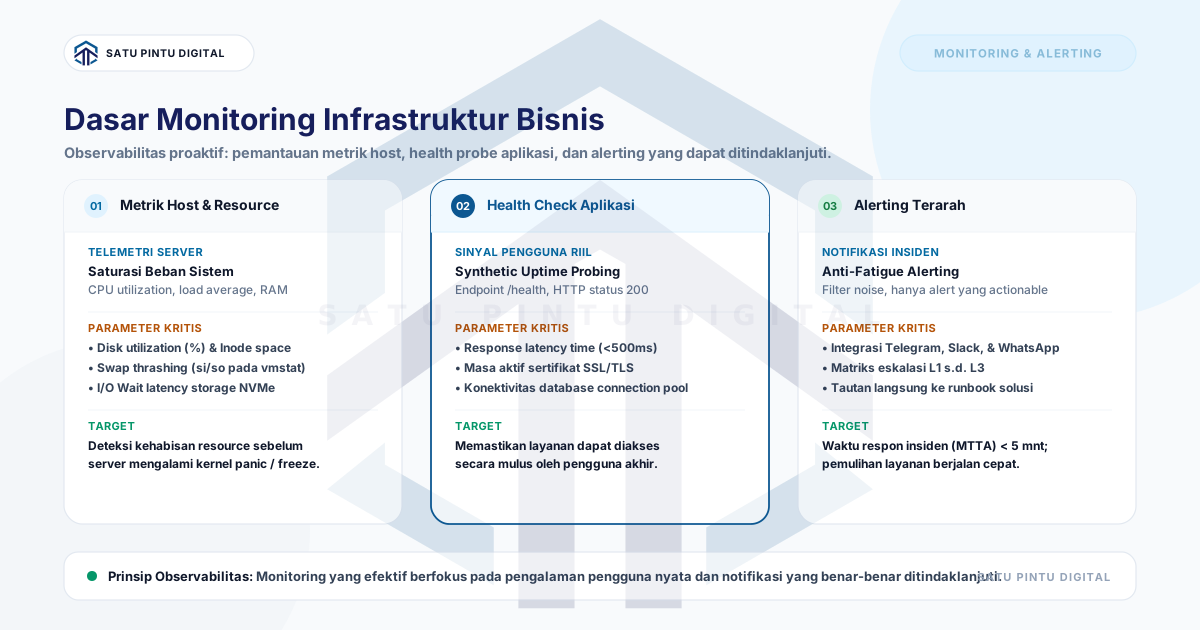
Dalam operasional infrastruktur digital, insiden terburuk bukanlah ketika server mengalami kegagalan mendadak, melainkan saat server melambat secara perlahan hingga akhirnya lumpuh tanpa diketahui penyebabnya.
Banyak tim operasional hanya mengandalkan keluhan pelanggan sebagai “alat monitoring” utama mereka. Padahal, sistem operasi modern selalu memberikan tanda-tanda peringatan awal (early warning signals) jauh sebelum kegagalan total terjadi.
Artikel ini membahas 4 metrik kritis yang wajib dipantau secara ketat beserta panduan konfigurasi batas peringatan (alert thresholds) yang tepat.
1. Empat Metrik Kritis Kesehatan Server
┌────────────────────────────────────────────────────────────────────────┐
│                   4 PILAR OBSERVABILITAS SERVER                        │
├────────────────────────────────────────────────────────────────────────┤
│  1. CPU & LOAD AVERAGE       ──► Kapasitas antrean komputasi CPU       │
│  2. MEMORY & SWAP ACTIVITY   ──► Risiko kebocoran memori (Memory Leak) │
│  3. DISK SPACE & I/O WAIT    ──► Hambatan transfer data storage disk   │
│  4. NETWORK & HTTP ERRORS    ──► Integritas transmisi dan lonjakan 5xx │
└────────────────────────────────────────────────────────────────────────┘
2. Rincian Metrik dan Ambang Batas Alerting
A. CPU Utilization & Load Average
- Apa yang Diperiksa: Utilisasi per-core CPU dan nilai Load Average 1 menit, 5 menit, dan 15 menit.
- Tanda Bahaya: Nilai Load Average melebihi total jumlah core vCPU server Anda (misal Load 8.0 pada server 4-core berarti ada 4 antrean proses yang tertahan).
- Konfigurasi Threshold Ideal:
- 🟡 Warning Alert: Utilisasi CPU > 75% selama 5 menit berturut-turut.
- 🔴 Critical Alert: Utilisasi CPU > 85% atau Load Avg > (Jumlah Core x 1.5).
B. Memory (RAM) & Swap In/Out
- Apa yang Diperiksa: Available Memory (bukan hanya Free Memory), serta aktivitas Swap paging.
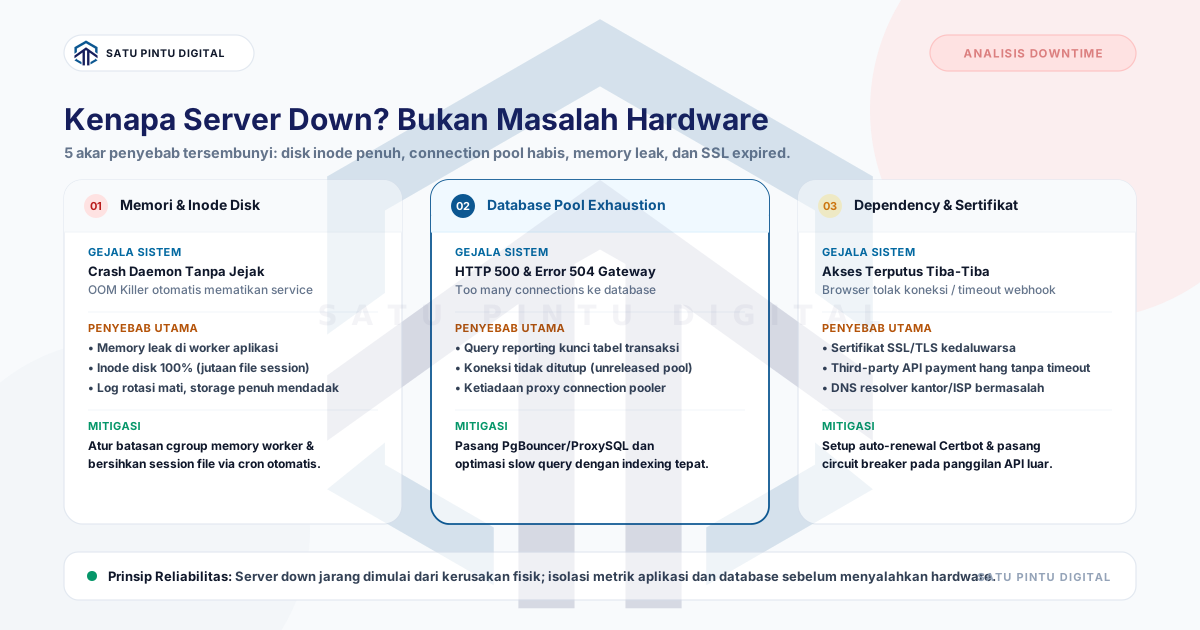
- Tanda Bahaya: Kapasitas Available Memory terus menurun setiap hari tanpa pernah naik kembali—ini indikasi nyata Memory Leak pada aplikasi yang akan memicu eksekusi OOM Killer.
- Konfigurasi Threshold Ideal:
- 🟡 Warning Alert: Available Memory tersisa < 20%.
- 🔴 Critical Alert: Available Memory < 10% atau aktivitas Swap I/O aktif terjadi terus-menerus.
C. Disk Space, Inodes, dan I/O Wait (%iowait)
- Apa yang Diperiksa: Ruang sisa partisi root (
/) dan data (/var), jumlah sisa Inodes, serta persentase iowait. - Tanda Bahaya: Nilai
%iowaittinggi (> 10%) menandakan bahwa CPU cepat Anda sedang “tercekik” menunggu respons lambat dari harddisk atau storage database. - Konfigurasi Threshold Ideal:
- 🟡 Warning Alert: Disk Space terpakai > 80% atau Inode > 80%.
- 🔴 Critical Alert: Disk Space terpakai > 90% atau
%iowait> 15% selama 3 menit.
D. Network Bandwidth & Error Rate
- Apa yang Diperiksa: Throughput Inbound/Outbound, persentase packet drop/errors, dan lonjakan status kode HTTP 5xx pada web server.
- Tanda Bahaya: Lonjakan drastis outbound traffic dapat mengindikasikan server Anda sedang disusupi malware untuk serangan DDoS keluar.
- Konfigurasi Threshold Ideal:
- 🟡 Warning Alert: Network packet drop > 1% atau lonjakan error 5xx > 2% dari total request.
- 🔴 Critical Alert: Server tidak merespons ICMP ping atau HTTP probe eksternal selama 60 detik.
3. Matriks Diagnosa Masalah Server Cepat
Gunakan tabel referensi berikut untuk mengidentifikasi akar masalah saat menerima notifikasi alert:
| Gejala Metrik | Indikasi Akar Masalah | Tindakan Cepat Tim IT |
|---|---|---|
| CPU 100%, iowait 0% | Perhitungan looping kode aplikasi / Serangan DDoS | Periksa top / htop, identifikasi PID proses terberat |
| CPU 20%, iowait 40% | Storage disk lambat / Query database tanpa index | Optimasi index tabel database / migrasi storage ke NVMe SSD |
| RAM terisi penuh, Swap naik | Memory leak pada runtime (PHP-FPM, Node.js, Java) | Restart service aplikasi secara berkala & profiling memory |
| Disk space masih 50%, tapi write gagal | Kehabisan Inode akibat jutaan file sesi/cache kecil | Jalankan df -i, bersihkan folder temp / cache sessions |
4. Beralih dari Monitoring Reaktif ke Proaktif
Banyak perusahaan gagal memanfaatkan monitoring karena sistem peringatan yang dibuat terlalu berisik (alert fatigue)—notifikasi masuk ribuan kali hingga akhirnya diabaikan oleh staf IT.
Prinsip monitoring yang efektif:
- Kirim Alert Hanya yang Membutuhkan Tindakan Manusia: Peringatan info cukup dicatat di log; notifikasi push/WhatsApp hanya untuk status Warning dan Critical.
- Sediakan Runbook Terintegrasi: Setiap pesan alert wajib menyertakan tautan ke SOP penanganan (misal: “Jika Disk /var penuh, hapus file rotasi log lama di path X”).
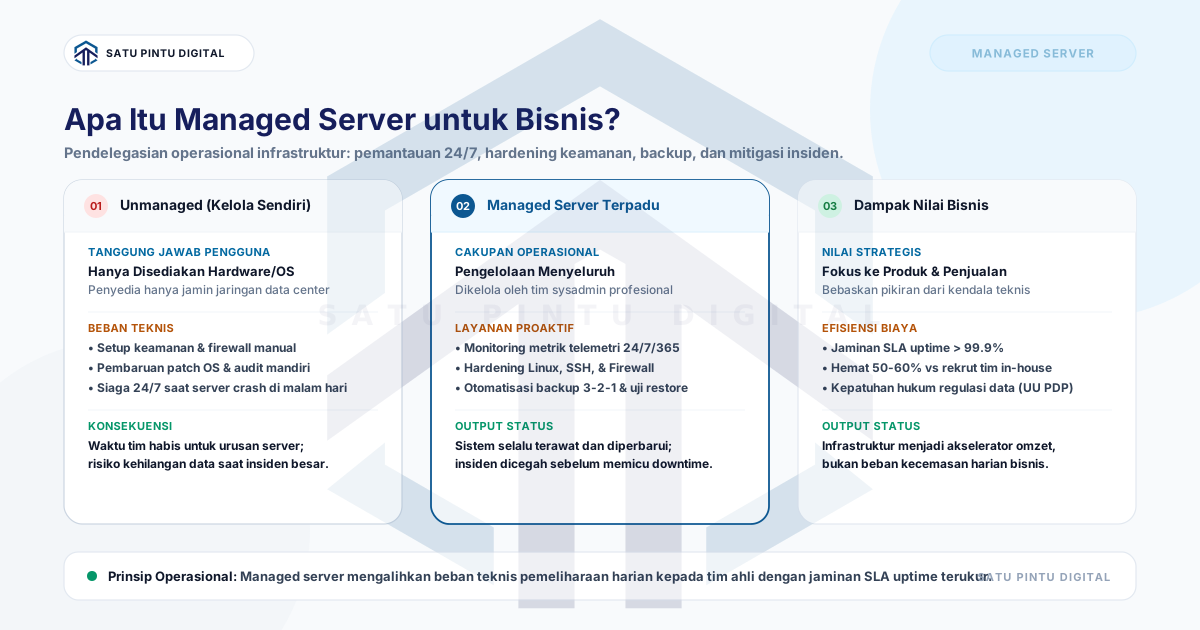
- Gunakan Tim Pengawas 24/7: Untuk bisnis dengan SLA ketat, pertimbangkan bekerja sama dengan penyedia Managed IT & Monitoring Service agar respon mitigasi berjalan otomatis di luar jam kerja kantor.
Kesimpulan
Menyiapkan sistem pemantauan server bukan tentang memasang dashboard visual yang rumit, melainkan tentang mengidentifikasi anomali sedini mungkin sebelum berdampak pada kelangsungan bisnis. Dengan mengawasi 4 metrik dasar ini, Anda mengeliminasi 90% potensi penyebab downtime server bisnis Anda.
Butuh bantuan mengelola dan memantau server bisnis Anda selama 24/7?
Pelajari Layanan Managed Server & Monitoring Satu Pintu Digital atau Konsultasikan Audit Infrastruktur Server Anda.
Butuh Solusi Managed IT & Arsitektur Server?
Diskusikan kebutuhan managed server, monitoring jaringan, dan perlindungan firewall untuk infrastruktur bisnis Anda.
Istilah penting
Glossary singkat
- Load Average
- Jumlah rata-rata proses komputasi yang sedang berjalan atau menunggu giliran dieksekusi CPU dalam rentang waktu 1, 5, dan 15 menit.
- I/O Wait (iowait)
- Persentase waktu CPU menganggur (idle) karena terpaksa menunggu proses baca/tulis data ke media penyimpanan (storage disk) selesai.
- OOM Killer (Out of Memory Killer)
- Mekanisme proteksi kernel Linux yang secara paksa mematikan proses aplikasi dengan konsumsi RAM terbesar saat memori fisik server habis total.
- MTTD (Mean Time to Detect)
- Rata-rata waktu yang dibutuhkan tim IT untuk menyadari adanya gangguan performa pada sistem sejak anomali pertama kali muncul.
Baca sumbernya
Referensi dan dokumentasi
- The USE Method - Utilization, Saturation, and Errors (Brendan Gregg) Metodologi standar industri rekayasa performa sistem untuk mendiagnosis bottleneck infrastruktur komputasi.
- Google Cloud Architecture Framework - System Observability Prinsip penyusunan dashboard monitoring dan manajemen insiden terstruktur.
Pertanyaan umum
Yang sering ditanyakan sebelum implementasi
- Mengapa metrik CPU 100% tidak selalu berarti server kelebihan beban?
- Lonjakan CPU singkat adalah hal normal saat mengeksekusi tugas berat terjadwal (seperti batch report atau backup). Yang berbahaya adalah jika CPU tinggi berlangsung terus-menerus selama lebih dari 5 menit disertai tingginya Load Average di atas jumlah core CPU.
- Berapa batas ambang aman alokasi ruang penyimpanan (Disk Space) server?
- Batas aman pemakaian disk adalah 80%. Sisa 20% ruang bebas sangat krusial untuk penulisan log sistem, file sementara database, serta proses update patch kernel tanpa memicu kegagalan sistem.
- Apa perbedaan antara pemantauan internal (Resource) dan eksternal (Synthetic)?
- Resource monitoring memantau kondisi fisik hardware dari dalam OS server (CPU/RAM), sedangkan Synthetic monitoring memantau ketersediaan aplikasi dari sudut pandang pengguna internet luar (HTTP status 200, response time, SSL validity).
Umpan balik
Apakah panduan ini membantu memahami arsitektur & keandalan server?
Artikel ini bagian dari catatan digital Satu Pintu Digital. Artikel berikutnya membahas topik yang berkaitan.
Content cluster